La cluster analysis clienti non è uno strumento per statistici: è un metodo per scoprire gruppi di acquirenti che si comportano in modo simile, senza dover decidere in anticipo chi sono. Il K-means è l’algoritmo più usato in ambito marketing perché è comprensibile, applicabile con strumenti diffusi e produce risultati immediatamente traducibili in azioni. Il vero lavoro non è matematico: è interpretare i cluster trovati e decidere cosa farci.
Se hai già un database clienti con qualche anno di storico, stai seduto su informazioni che la maggior parte delle analisi di marketing non riesce a sfruttare. La segmentazione classica — per fascia d’età, area geografica, categoria di prodotto acquistata — descrive i clienti in base a caratteristiche dichiarate o ovvie. La cluster analysis fa qualcosa di diverso: lascia che siano i dati a rivelare i gruppi, senza imporre categorie decise a tavolino.
Questa distinzione non è tecnica, è strategica. Nella nostra consulenza Business Intelligence per imprenditori e marketing manager, la cluster analysis è uno degli strumenti che produciamo risultati più concreti proprio perché porta alla luce segmenti che nessuno aveva pensato di cercare. In questa guida spieghiamo come funziona l’algoritmo K-means, quali dati servono realmente, come scegliere il numero di gruppi, come dare un nome ai segmenti trovati e — soprattutto — come tradurli in decisioni di marketing che abbiano senso per un’azienda che vende prodotti o servizi.
Indice
- Cos’è la cluster analysis e perché è diversa dalla segmentazione classica
- Come funziona il K-means: l’intuizione senza le formule
- Quali dati servono e come prepararli
- Come scegliere il numero giusto di cluster
- Come interpretare i cluster trovati e dargli un nome
- Dalla cluster analysis alle azioni di marketing: il passaggio che molti saltano
- I limiti della cluster analysis che è onesto riconoscere
- Domande frequenti
- Conclusione
Cos’è la cluster analysis e perché è diversa dalla segmentazione classica
La cluster analysis è una tecnica di apprendimento automatico non supervisionato. In termini pratici significa che l’algoritmo non riceve istruzioni su quanti gruppi cercare né su quali caratteristiche debbano avere: analizza i dati e trova da solo le strutture di somiglianza interne.
Questo la distingue in modo netto da altri approcci che molte aziende già usano. La segmentazione per caratteristiche demografiche — età, sesso, città — divide i clienti in base a variabili che conosci prima di guardare i dati. Il metodo RFM (Recency, Frequency, Monetary value) applica regole predefinite: chi ha comprato di recente, spesso e per importi elevati finisce in un cluster “top”, chi non compra da mesi finisce in un cluster “a rischio abbandono”. Entrambi gli approcci sono utili e hanno senso in contesti precisi — esistono guide dedicate che li trattano nel dettaglio — ma condividono un limite: il risultato dipende dalle categorie che hai scelto tu, non da quelle che esistono nei dati.
Quando la cluster analysis produce insight che gli altri metodi non vedono
Il valore della cluster analysis emerge soprattutto quando le somiglianze tra clienti sono trasversali rispetto alle categorie ovvie. Un esempio tipico in ambito ecommerce: potresti scoprire che esiste un gruppo di clienti che acquista raramente ma con carrelli molto elevati, sempre nella stessa categoria di prodotto e prevalentemente di notte. Nessuna segmentazione demografica te lo avrebbe mostrato, e nemmeno un’analisi RFM standard, perché la frequenza bassa li avrebbe penalizzati. La cluster analysis, invece, li raggruppa insieme perché si comportano in modo simile lungo più dimensioni contemporaneamente.
Questo è il punto chiave: il clustering lavora in modo multidimensionale. Non classifica i clienti su una singola variabile, ma trova gruppi che sono simili su più variabili insieme. Ed è proprio questa capacità a renderlo potente per chi deve decidere come comunicare, cosa proporre e quando intervenire su segmenti diversi del proprio database.
La cluster analysis descrive pattern esistenti nei dati. Non spiega perché esistono, non prevede comportamenti futuri e non garantisce che i gruppi trovati siano stabili nel tempo. Questa onestà sui limiti è il punto di partenza per usarla bene.
Come funziona il K-means: l’intuizione senza le formule
Il K-means è l’algoritmo di clustering più usato in ambito marketing, non perché sia il più sofisticato, ma perché è comprensibile, veloce e produce risultati interpretabili. Ecco come funziona, senza formule.
Il meccanismo in tre passaggi
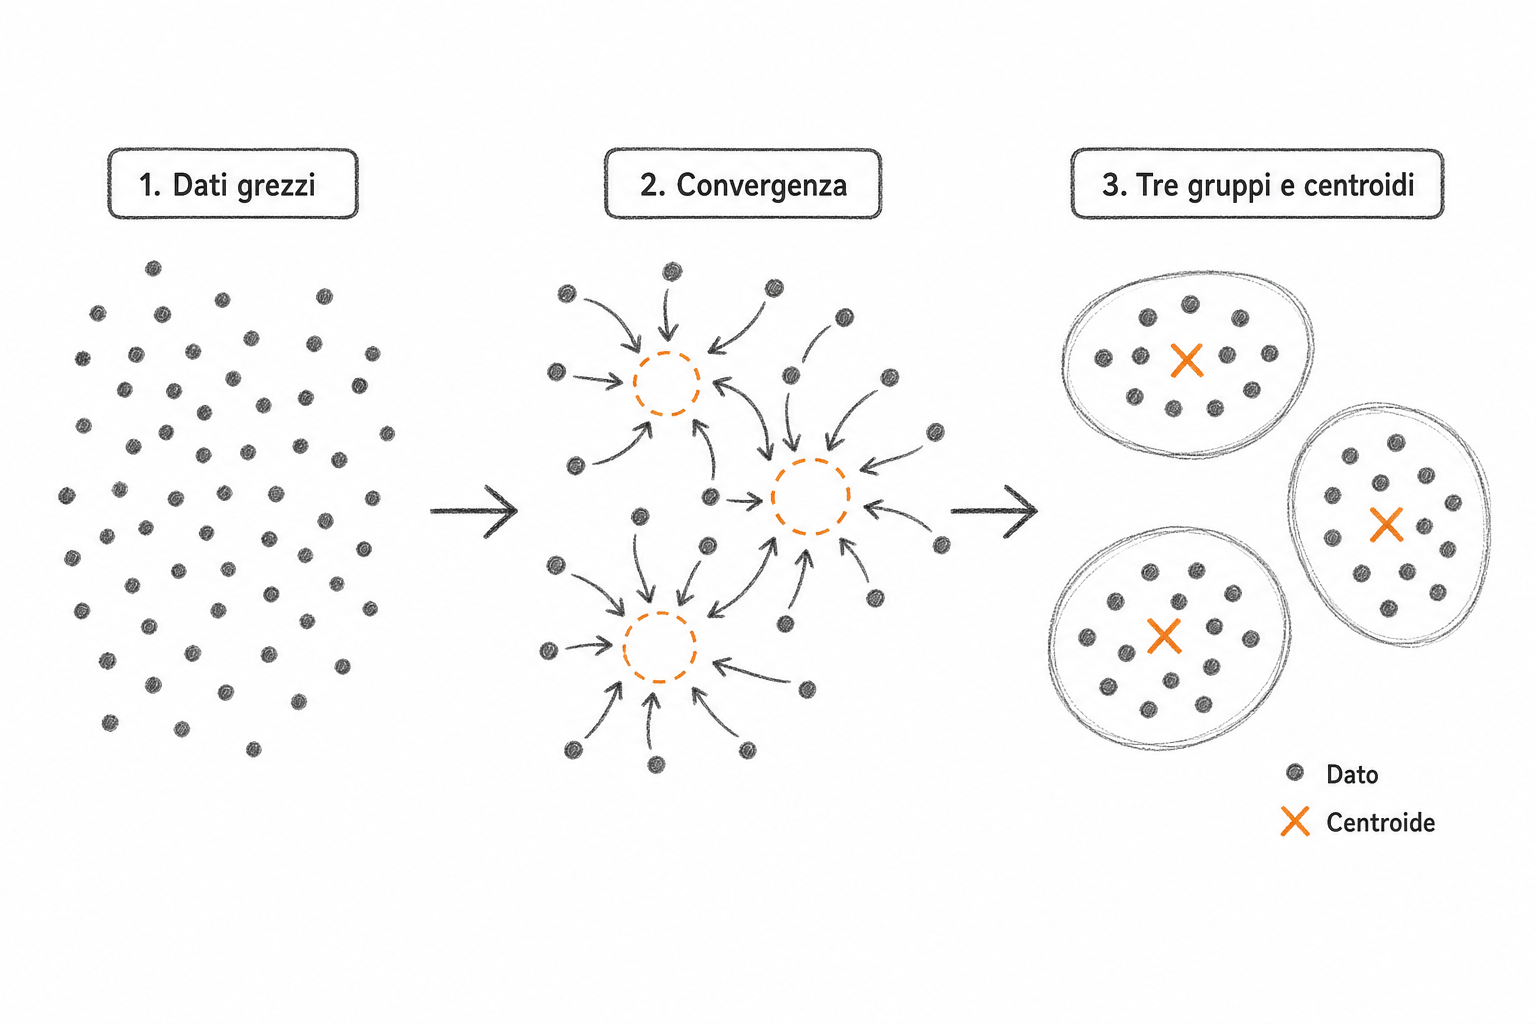
Immagina di avere mille clienti rappresentati come punti su un piano. Ogni punto ha coordinate che corrispondono ai valori delle variabili che hai scelto — per esempio, spesa media per ordine sull’asse orizzontale e frequenza di acquisto sull’asse verticale. Il K-means funziona così.
Prima fase: scegli un numero K di cluster che vuoi trovare — diciamo 4. L’algoritmo posiziona 4 punti di riferimento iniziali (chiamati centroidi) in modo casuale nello spazio dei dati.
Seconda fase: ogni cliente viene assegnato al centroide più vicino. Si formano così 4 gruppi provvisori.
Terza fase: per ciascun gruppo, l’algoritmo ricalcola il centroide come media di tutti i punti assegnati a quel gruppo. I centroidi si spostano. Poi si riassegnano tutti i clienti ai nuovi centroidi più vicini. E si ricalcolano ancora i centroidi. Questo ciclo continua fino a quando i centroidi non si spostano più in modo significativo: a quel punto l’algoritmo ha trovato una soluzione stabile.
Il risultato è K gruppi di clienti, ognuno dei quali è internamente il più omogeneo possibile e il più diverso possibile dagli altri gruppi. Questo criterio — massimizzare la somiglianza interna e la differenza esterna — è il cuore della logica del clustering.
Cosa significa “distanza” in questo contesto
L’algoritmo misura la somiglianza tra clienti calcolando la distanza tra i loro punti nello spazio multidimensionale. Più due clienti hanno valori simili su tutte le variabili considerate, più sono vicini nello spazio e più probabilmente finiranno nello stesso cluster. Questo implica una conseguenza pratica importante: le variabili con valori molto grandi (come la spesa totale in euro) tendono a dominare il calcolo rispetto a variabili con valori piccoli (come il numero di ordini). Per questo, prima di applicare il K-means, è necessario normalizzare i dati — riportare tutte le variabili su una scala comparabile.
Quali dati servono e come prepararli
La qualità dei cluster dipende quasi interamente dalla qualità e dalla scelta delle variabili in ingresso. Questo è il passaggio che richiede più giudizio umano, non tecnico.
Le variabili comportamentali che funzionano meglio
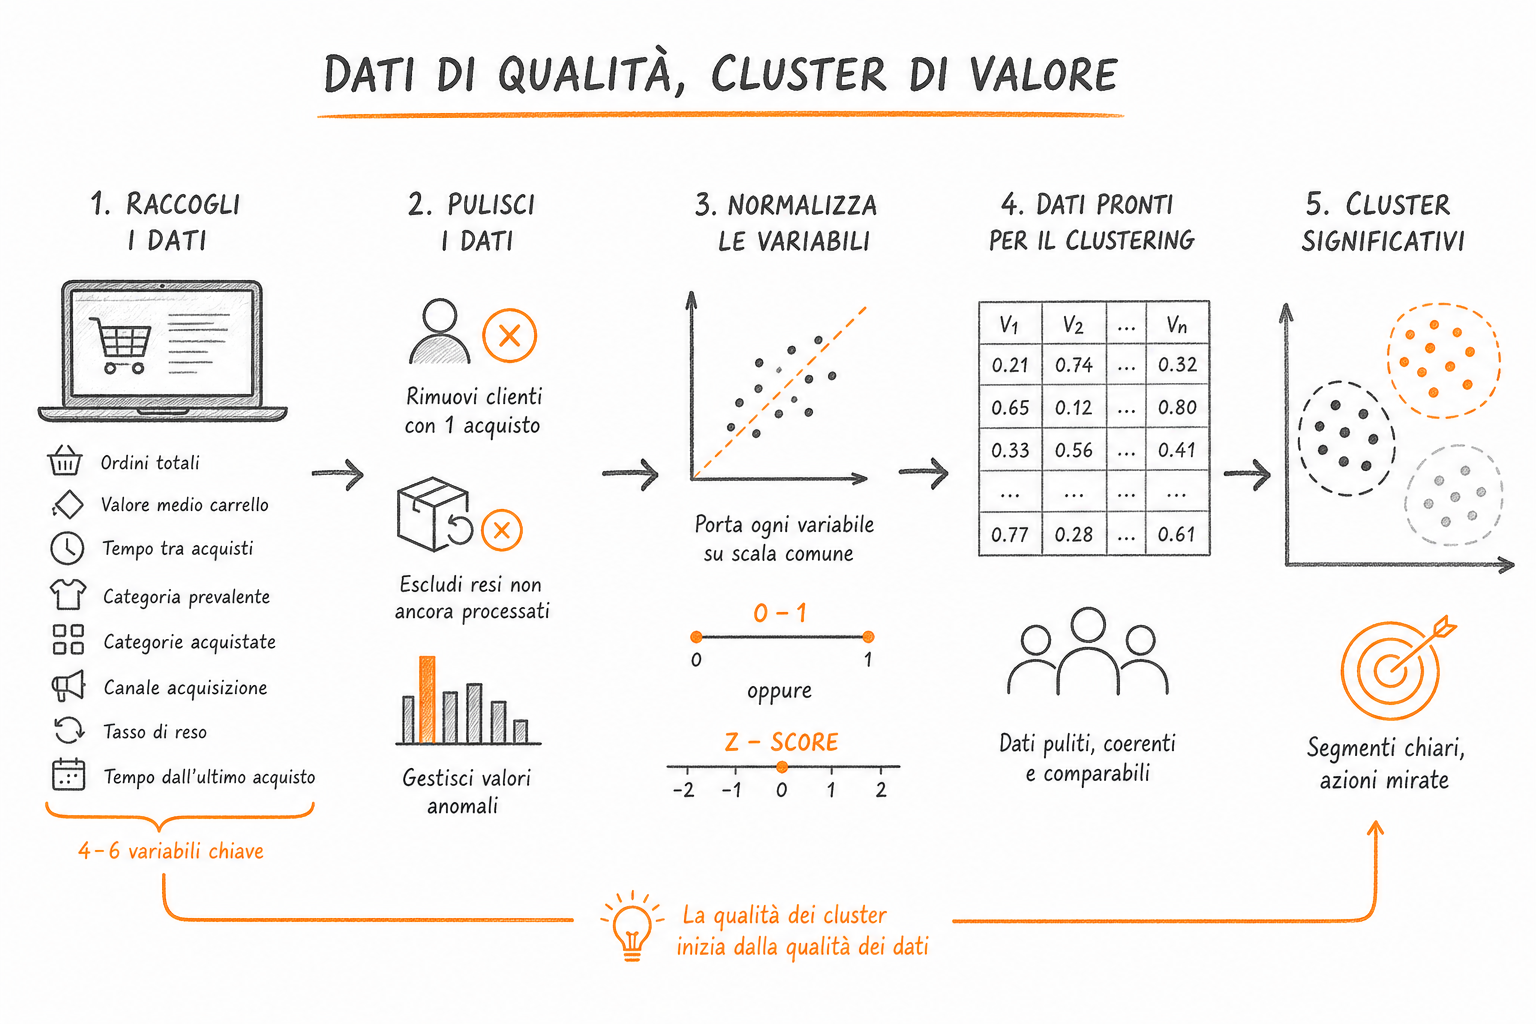
Per un ecommerce, le variabili più efficaci per la cluster analysis clienti sono quelle che descrivono il comportamento di acquisto nel tempo, non le caratteristiche anagrafiche. Le più comuni e utili sono: il numero totale di ordini nell’arco temporale considerato, il valore medio del carrello, il tempo medio tra un acquisto e il successivo, la categoria di prodotto prevalente, il numero di categorie diverse acquistate (indice di ampiezza del comportamento), il canale di acquisizione originale, il tasso di restituzione dei prodotti, il tempo trascorso dall’ultimo acquisto.
Non è necessario usarle tutte insieme. Anzi, aggiungere troppe variabili produce cluster difficili da interpretare. Una buona regola pratica è partire da 4-6 variabili che rappresentano dimensioni distinte del comportamento del cliente.
Pulizia e normalizzazione: il lavoro invisibile che decide tutto
Prima di applicare qualsiasi algoritmo, i dati devono essere puliti. Questo significa rimuovere i clienti con un solo acquisto se stai analizzando la fedeltà, escludere i resi non ancora processati, gestire i valori anomali estremi (un cliente che ha speso dieci volte la media degli altri può distorcere l’intero cluster). La normalizzazione porta poi ogni variabile su una scala comune — tipicamente tra 0 e 1, o con media 0 e deviazione standard 1 — in modo che nessuna variabile domini le altre per effetto della sua scala numerica.
Questo lavoro preparatorio, che spesso occupa la maggior parte del tempo di un’analisi, è anche quello che distingue un risultato utile da uno fuorviante. I cluster riflettono fedelmente i dati che ricevono: se i dati sono sporchi o mal bilanciati, i gruppi trovati saranno altrettanto inaffidabili.
Come scegliere il numero giusto di cluster
Il parametro K — quanti cluster cercare — è la decisione più delicata dell’intera analisi. Non esiste una risposta matematica universale: esistono strumenti che aiutano a orientarsi e poi c’è il giudizio di chi deve usare i risultati.
Il metodo del gomito e la silhouette score
Il metodo più diffuso per scegliere K si chiama “elbow method” (metodo del gomito). Consiste nel calcolare l’errore interno dei cluster — quanto i punti sono distanti dal proprio centroide — per diversi valori di K, da 2 a 10 o più. Questo errore diminuisce sempre all’aumentare di K: con K uguale al numero di clienti, ogni cliente è il proprio cluster e l’errore è zero. Il punto interessante è quello in cui la curva smette di scendere bruscamente e inizia a scendere più lentamente: è il “gomito”, e suggerisce il numero di cluster oltre il quale aggiungerne altri produce poca utilità aggiuntiva.
Un secondo strumento è la silhouette score, che misura quanto ogni punto è ben assegnato al proprio cluster rispetto agli altri. Valori vicini a 1 indicano cluster ben separati, valori vicini a 0 indicano che il punto è al confine tra due cluster, valori negativi segnalano assegnazioni probabilmente errate.
Il criterio pratico che conta davvero
Oltre agli strumenti statistici, c’è un criterio pratico che spesso è più decisivo: i cluster trovati devono essere interpretabili e azionabili. Se con K=6 ottieni sei gruppi statisticamente distinti ma non riesci a dare un nome sensato a tre di essi, probabilmente hai esagerato. Se con K=3 ottieni tre gruppi chiari ma uno di essi è così eterogeneo che non sai come comunicare con chi ne fa parte, probabilmente ne servono di più.
La scelta di K è quindi un dialogo tra la matematica e il business. Un buon punto di partenza per la maggior parte dei database ecommerce è tra 3 e 6 cluster: abbastanza per cogliere la diversità dei comportamenti, non così tanti da rendere impossibile la gestione operativa dei segmenti.
| K scelto | Vantaggio | Rischio |
|---|---|---|
| 2-3 | Facile da gestire e comunicare | Gruppi troppo eterogenei internamente |
| 4-5 | Buon equilibrio tra dettaglio e usabilità | Richiede interpretazione attenta |
| 6+ | Massima granularità comportamentale | Difficile da tradurre in azioni distinte |
La tabella sintetizza il compromesso fondamentale: più cluster significano più dettaglio, ma anche più complessità operativa. La scelta dipende da quante versioni diverse di comunicazione e offerta sei in grado di gestire concretamente.
Come interpretare i cluster trovati e dargli un nome
Trovare i cluster è la parte automatica. Capire cosa significano è la parte umana, ed è quella che produce valore reale.
Leggere il profilo medio di ogni cluster
Una volta applicato il K-means, ogni cliente ha un’etichetta che indica il cluster di appartenenza. Il passo successivo è calcolare i valori medi di ogni variabile per ciascun cluster e confrontarli tra loro. Questo profilo medio — il centroide — racconta chi è il cliente tipico di quel gruppo.
Immagina di avere trovato 4 cluster su un database ecommerce di prodotti per la casa. Il cluster 1 ha carrello medio alto, frequenza bassa, tasso di restituzione quasi nullo e acquisti concentrati in una sola categoria. Il cluster 2 ha carrello medio basso, frequenza molto alta, molte categorie diverse e un tasso di restituzione elevato. Il cluster 3 ha frequenza media, carrello medio, e il tempo dall’ultimo acquisto è molto lungo. Il cluster 4 ha frequenza alta, carrello medio-alto e acquisti distribuiti su più categorie.
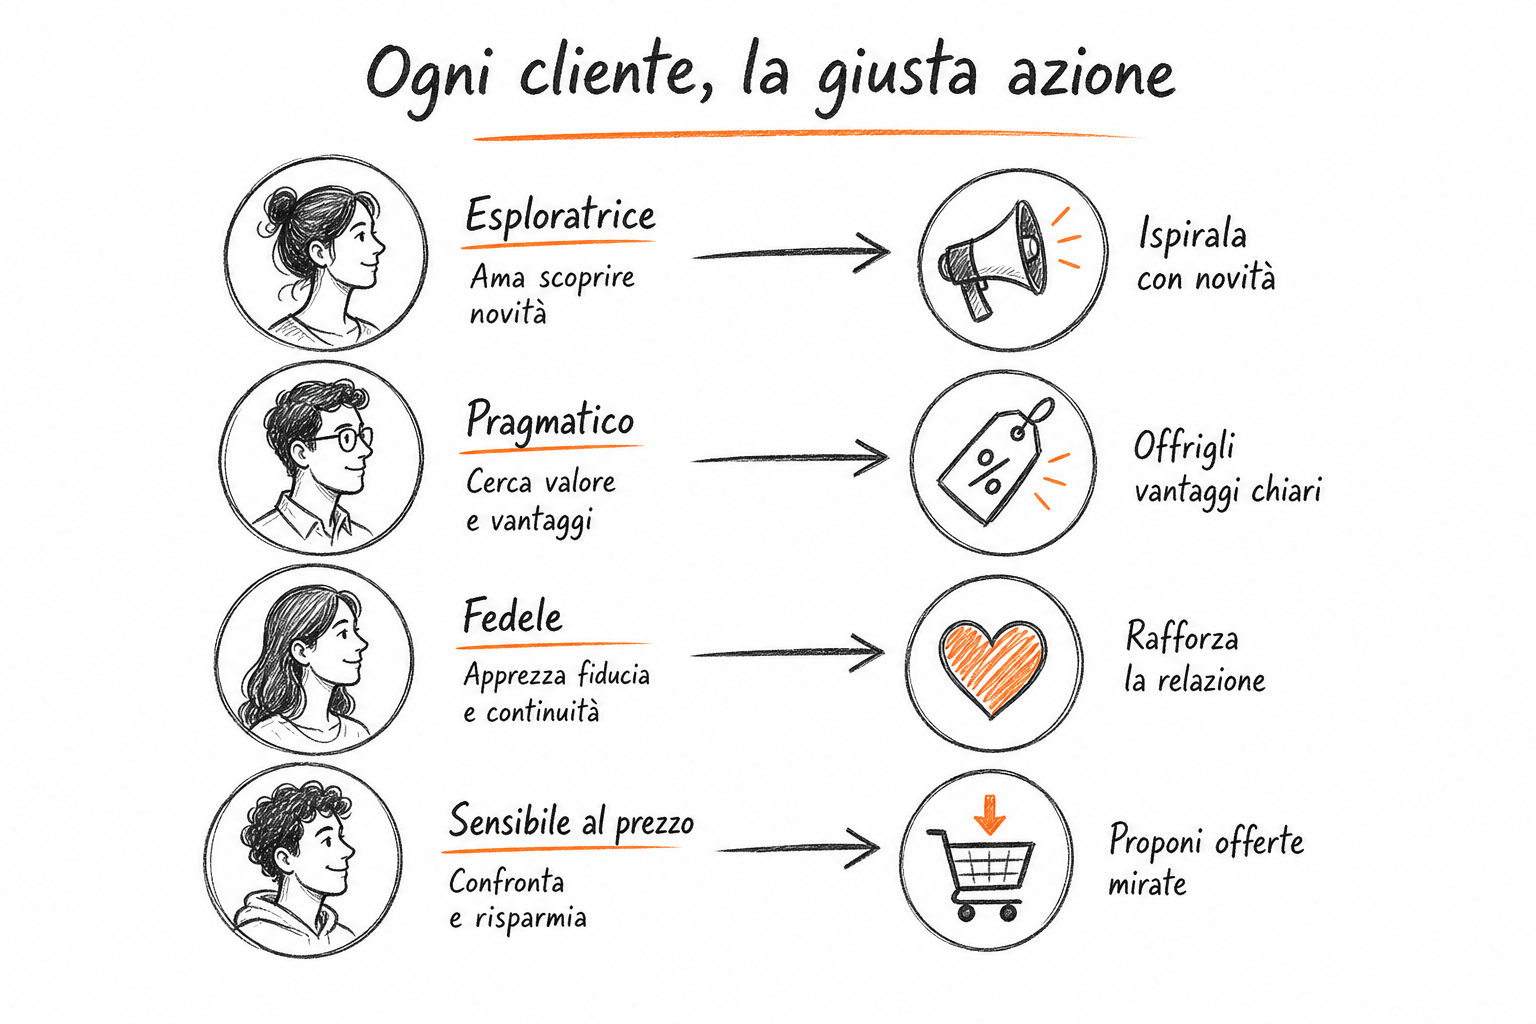
Leggendo questi profili, puoi iniziare a dare nomi ai segmenti: il cluster 1 potrebbe essere “il cliente specialista” — compra poco ma bene, sa cosa vuole. Il cluster 2 potrebbe essere “il cliente esploratore” — prova tutto, restituisce spesso, è difficile da fidelizzare. Il cluster 3 è probabilmente “il cliente dormiente” — ha comprato in passato ma non si fa più vivo. Il cluster 4 è “il cliente fedele attivo” — il segmento più prezioso.
Perché nominare i cluster è un atto strategico
Dare un nome a ogni segmento non è un esercizio comunicativo: è un atto che forza il team a prendere una posizione su cosa rappresenta quel gruppo e cosa si vuole fare con esso. Un cluster senza nome è un numero in una tabella. Un cluster chiamato “cliente dormiente” genera immediatamente una domanda: cosa facciamo per risvegliarlo?
Questo collegamento diretto tra nome del segmento e domanda operativa è il segnale che l’analisi sta funzionando. Se i nomi che dai ai cluster non generano domande di marketing, probabilmente i cluster non sono abbastanza distinti o le variabili scelte non erano quelle giuste.
Per approfondire come trasformare questo tipo di analisi in decisioni concrete, l’articolo su come trasformare i dati di marketing in decisioni strategiche offre un quadro metodologico utile per il passaggio successivo.
Dalla cluster analysis alle azioni di marketing: il passaggio che molti saltano
Trovare i cluster e nominarli è ancora analisi. Il valore si realizza solo quando i segmenti guidano decisioni concrete su comunicazione, offerta e budget.
Azioni diverse per segmenti diversi
Riprendendo l’esempio ecommerce precedente, ogni cluster suggerisce un approccio diverso. Per il “cliente specialista” — alto valore, bassa frequenza — l’obiettivo è aumentare la frequenza senza compromettere la percezione di qualità. Comunicazioni personalizzate sulle novità della categoria che predilige, accesso anticipato a nuovi prodotti, programmi fedeltà basati sul valore piuttosto che sulla frequenza.
Per il “cliente esploratore” — alta frequenza, alta restituzione — il problema non è la frequenza ma la qualità delle conversioni. Ha senso investire in contenuti che aiutino a scegliere meglio prima dell’acquisto, ridurre le aspettative disallineate con descrizioni più precise, eventualmente valutare se questo segmento è redditizio al netto dei costi di gestione dei resi.
Per il “cliente dormiente” — lungo tempo dall’ultimo acquisto — la priorità è la riattivazione. Campagne email con incentivi temporanei, messaggi che ricordano cosa ha acquistato in passato, offerte sulla categoria di maggiore interesse storico. Se il cluster è numericamente grande, vale la pena capire quando è avvenuto il “sonno” e se c’è un pattern temporale comune.
Per il “cliente fedele attivo” — il segmento più prezioso — l’obiettivo è la protezione e l’espansione. Programmi di fidelizzazione, accesso a servizi premium, inviti a referral. Questo è anche il segmento da studiare più attentamente per capire cosa lo ha reso tale, perché quelle caratteristiche potrebbero guidare l’acquisizione di nuovi clienti simili.
Il collegamento con le campagne pubblicitarie
I cluster possono essere esportati e usati direttamente nelle piattaforme pubblicitarie. Caricare i clienti di un cluster come audience personalizzata permette di creare campagne mirate su quel segmento specifico, oppure di costruire audience simili per acquisire nuovi clienti con caratteristiche comportamentali analoghe. Questo collegamento tra analisi interna e attivazione esterna è uno dei modi più efficaci per trasformare la cluster analysis da esercizio descrittivo a leva di crescita concreta.
Per chi vuole costruire un sistema di monitoraggio che tenga traccia dei segmenti nel tempo, l’articolo su come costruire una dashboard marketing utile per il management offre indicazioni pratiche su come strutturare la reportistica.
I limiti della cluster analysis che è onesto riconoscere
La cluster analysis è potente, ma non è uno strumento infallibile. Conoscere i suoi limiti è parte integrante di un uso professionale.
Il primo limite è che i cluster descrivono, non spiegano. Sapere che esiste un gruppo di clienti che compra raramente ma con carrelli alti non dice nulla sul perché si comportano così. La spiegazione richiede analisi aggiuntive, ipotesi e talvolta ricerca qualitativa.
Il secondo limite è la stabilità nel tempo. I cluster trovati oggi riflettono i comportamenti registrati fino ad oggi. Se il mercato cambia, se lanci nuove categorie di prodotto o se cambia il mix di acquisizione, i cluster possono cambiare forma. È buona pratica rieseguire l’analisi periodicamente — almeno ogni anno, o dopo cambiamenti significativi nel business.
Il terzo limite riguarda la scelta delle variabili. Il K-means trova i cluster migliori rispetto alle variabili che gli dai. Se scegli variabili poco rilevanti, trovi cluster poco rilevanti. Non c’è algoritmo che compensi una scelta sbagliata delle dimensioni di analisi.
Il quarto limite è la sensibilità ai valori anomali. Un piccolo numero di clienti con comportamenti estremi può influenzare significativamente la posizione dei centroidi e quindi la forma di tutti i cluster. Identificare e gestire questi casi prima dell’analisi è parte del lavoro preparatorio.
Riconoscere questi limiti non riduce l’utilità della cluster analysis: la inquadra correttamente come uno strumento di esplorazione e orientamento, non come un oracolo.
Domande frequenti
Cos’è la cluster analysis applicata ai clienti?
La cluster analysis clienti è una tecnica statistica che raggruppa automaticamente i clienti in segmenti omogenei basandosi sul loro comportamento reale, senza categorie predefinite. A differenza della segmentazione classica, non imponi tu i gruppi: sono i dati a rivelarli. Il risultato è un insieme di segmenti internamente simili e reciprocamente diversi, utili per personalizzare comunicazione e offerta.
Cos’è il K-means e come funziona in modo semplice?
Il K-means è l’algoritmo di clustering più usato in marketing. Funziona posizionando K punti di riferimento (centroidi) nello spazio dei dati, assegnando ogni cliente al centroide più vicino, ricalcolando i centroidi come media del gruppo e ripetendo il ciclo fino a stabilità. Il risultato sono K gruppi di clienti simili tra loro e diversi dagli altri gruppi.
Quanti cluster devo scegliere per la segmentazione clienti?
Non esiste una risposta universale. Gli strumenti statistici come il metodo del gomito e la silhouette score aiutano a orientarsi, ma il criterio decisivo è pratico: i cluster devono essere interpretabili e azionabili. Per la maggior parte dei database ecommerce, un numero tra 3 e 6 cluster offre un buon equilibrio tra dettaglio e gestibilità operativa.
Quali dati servono per fare una cluster analysis dei clienti?
Le variabili comportamentali funzionano meglio di quelle demografiche: frequenza di acquisto, valore medio del carrello, tempo dall’ultimo acquisto, categorie preferite, tasso di restituzione, numero di categorie diverse acquistate. È importante scegliere 4-6 variabili che rappresentino dimensioni distinte del comportamento, normalizzarle su scala comparabile e pulire i dati prima dell’analisi.
In cosa si differenzia la cluster analysis dall’analisi RFM?
L’analisi RFM applica regole predefinite su tre dimensioni fisse (Recency, Frequency, Monetary value) e classifica i clienti in base a soglie stabilite a priori. La cluster analysis non ha regole predefinite: trova i gruppi direttamente nei dati, su qualsiasi combinazione di variabili. I due approcci sono complementari, non alternativi: RFM è più immediato, il clustering è più esplorativo.
Come si interpretano i cluster trovati?
Si calcola il profilo medio di ogni cluster — i valori medi di ciascuna variabile per quel gruppo — e lo si confronta con gli altri. Da questo profilo emerge la “personalità” del segmento, che va tradotta in un nome operativo (es. “cliente dormiente”, “cliente specialista”). Un buon nome genera automaticamente una domanda di marketing: cosa facciamo con questo segmento?
La cluster analysis garantisce risultati stabili nel tempo?
No. I cluster riflettono i comportamenti registrati fino al momento dell’analisi. Se cambia il mix di prodotti, i canali di acquisizione o le abitudini dei clienti, i segmenti possono cambiare forma. È consigliabile rieseguire l’analisi almeno una volta all’anno o dopo cambiamenti significativi nel business, per verificare che i segmenti siano ancora validi e rappresentativi.
Conclusione
La cluster analysis clienti è uno degli strumenti più concreti che la business intelligence mette a disposizione del marketing: non richiede una laurea in statistica, richiede chiarezza sulle domande che si vogliono rispondere e rigore nella preparazione dei dati. Il K-means trova i gruppi, ma sei tu a decidere cosa significano e cosa farne — ed è in quel passaggio che si decide se l’analisi produce valore o rimane un esercizio tecnico. Se vuoi capire come applicare questo approccio al tuo database clienti, il nostro servizio di business intelligence è il punto di partenza giusto.
